数据处理软件 从概念到实践
在数字化时代,数据已成为核心生产要素。原始数据往往杂乱无章、结构各异,无法直接用于分析或决策。数据处理软件正是架设在原始数据与业务价值之间的桥梁,它通过系统化的操作,将海量、低质的数据转化为清洁、可信、可用的信息资产。本文将从数据处理的核心内涵出发,梳理主流软件类型,探讨选型策略与未来趋势,为读者构建一幅完整的数据处理软件全景图。
一、数据处理的核心内涵
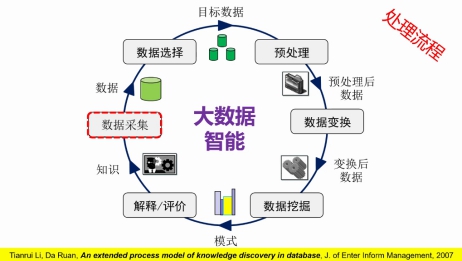
数据处理并非简单的“清洗”或“统计”,而是一个包含多个环节的完整流程:
- 数据采集:从数据库、API、日志文件、传感器、网页等多种源头获取数据。
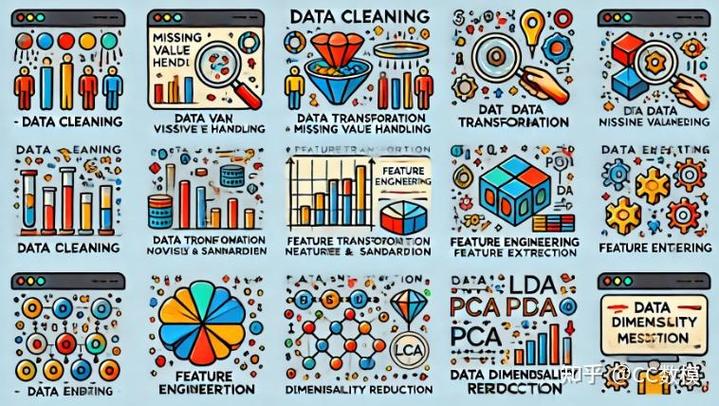
- 数据清洗:处理缺失值、异常值、重复记录,统一格式与单位。
- 数据转换:进行标准化、归一化、编码转换、聚合、连接等操作,使数据符合分析模型的要求。
- 数据存储与管理:将处理后的数据写入数据库、数据仓库或数据湖,并建立元数据管理、血缘追踪机制。
- 数据分析与呈现:通过统计、可视化、报表等方式挖掘洞察。
在不同行业与场景中,数据处理的侧重点各异:金融领域强调交易的准确性与合规性;电商关注用户行为数据的实时处理;科研场景则常涉及高维信号与图像数据的批量化清洗。但无论领域如何,数据处理软件的目标是一致的:提升数据质量、降低人工成本、保障处理过程的可重复性与可审计性。
二、数据处理软件的主要类型
1. 电子表格软件
以Excel、Google Sheets为代表,适合小规模数据的快速整理、公式计算与简单图表制作。其优势是门槛低、灵活直观,但在处理海量数据、多源整合与自动化流程方面存在明显局限。
2. 编程语言与库
Python(Pandas、NumPy、Polars)与R语言是数据科学领域的主力。配合Jupyter Notebook,用户可以实现从清洗、转换到建模的全流程控制,灵活度极高,适合探索性分析与定制化处理。规模增加时,可借助Dask、PySpark等分布式框架扩展能力。
3. ETL/ELT工具
Informatica、Talend、Apache NiFi、Airbyte等工具专注于数据的抽取、转换与加载。它们提供可视化的流程设计、调度监控与错误处理机制,是企业级数据集成与数据仓库建设的重要支撑。现代ELT模式更强调先将原始数据加载至目标端,再利用目标端算力完成转换。
4. 数据库与数据仓库
PostgreSQL、MySQL等关系型数据库支持SQL层面的数据处理;ClickHouse、Snowflake、BigQuery、Redshift等分析型数据库/数仓则针对大规模聚合查询做了优化。SQL作为一种声明式语言,在数据转换与聚合方面具有不可替代的地位。
5. 商业智能与可视化工具
Tableau、Power BI、FineBI等工具不仅提供图表与仪表板,也内置了数据准备模块,支持连接多源数据、进行行列转换、计算字段与清洗操作。它们降低了业务人员参与数据处理的门槛。
6. 大数据处理平台
Hadoop MapReduce、Apache Spark、Apache Flink构成了大数据处理的核心基础设施。Spark以内存计算见长,适合批处理与机器学习;Flink则以流处理为核心,支持实时ETL与事件驱动应用。
7. 专业领域软件
在统计调查领域有SPSS、SAS;在GIS领域有ArcGIS、QGIS;在生物信息领域有Bioconductor等。这些软件针对特定数据类型(如问卷、空间数据、基因序列)提供了专业化的处理算法与工作流。
三、如何选择合适的数据处理软件
选择合适的工具,需要从五个维度进行权衡:
- 数据规模:GB级以下可优先考虑Pandas或电子表格;TB级以上需引入Spark、Flink或分布式数仓。
- 实时性要求:离线批处理可选Spark、传统ETL;实时流处理则需Flink、Kafka Streams等。
- 团队技能:业务人员更适合可视化ETL工具或BI软件;数据工程师则倾向于编程与平台化方案。
- 成本与生态:开源方案成本低但需要运维投入;商业软件提供支持但许可费用较高。需同时评估与现有技术栈的集成难度。
- 合规与安全:涉及敏感数据时,需考虑工具的权限控制、审计日志、数据脱敏能力及部署方式(云端或本地)。
实践中的常见误区是“唯工具论”,即盲目追求最新框架而忽视业务需求与团队能力。相反,应当以“够用、可维护、可扩展”为原则,允许不同工具在流水线中各司其职:例如用Python做原型验证,用Airbyte完成数据同步,用dbt进行SQL转换,用Airflow编排调度。
四、典型应用场景
- 企业报表自动化:通过ETL工具定时抽取业务系统数据,经过清洗聚合后写入数据仓库,再由BI工具生成日报与看板,替代手工汇总。
- 用户行为分析:采集App与网站的埋点日志,利用Flink进行实时会话识别与指标计算,支撑推荐与运营决策。
- 科研数据整编:对实验仪器输出的原始文件进行批量格式转换、去噪与标准化,形成可共享的分析数据集。
- 金融风控数据准备:整合交易、征信、设备等多源数据,完成缺失值填充与特征衍生,为反欺诈模型提供输入。
五、未来趋势
数据处理软件正朝着更智能、更实时、更融合的方向演进:
- AI增强的数据处理:大模型与自动机器学习被用于自动识别数据质量问题、生成清洗规则、推荐转换步骤,降低人工配置成本。
- 流批一体化:Flink、Spark等平台持续融合批处理与流处理能力,统一开发范式,减少两套体系带来的维护负担。
- DataOps与可观测性:将DevOps理念引入数据管道,强调版本控制、自动化测试、血缘追踪与异常监控,提升数据处理流程的可靠性与可审计性。
- 云原生与Serverless化:数据处理的算力调度更加弹性,用户按需付费,免去基础设施运维负担。
- 数据编织(Data Fabric):通过元数据驱动的智能层,自动发现、集成和治理分布式数据源,使数据处理从“搬运”转向“连接”。
##
数据处理软件是数据价值释放的起点。理解自身数据特点与业务目标,合理组合表格、编程库、ETL工具与大数据平台,才能构建高效、可靠的数据处理流水线。随着智能化与实时化能力的增强,数据处理的门槛将进一步降低,但“以业务为导向、以质量为生命”的原则不会改变。选择合适的软件,本质上是在选择一种可持续的数据工作方式。
如若转载,请注明出处:http://www.newbeedata.com/product/44.html
更新时间:2026-11-01 04:31:47