数据预处理在建模中的重要性与常见方法——数据清洗篇
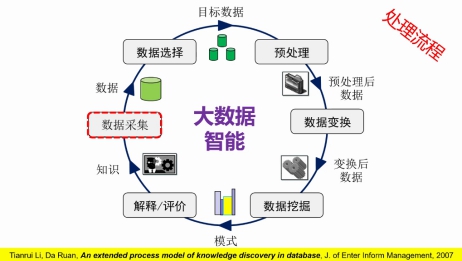
在数据驱动的时代,建模是提取洞见和预测未来的关键步骤。现实世界的数据往往充斥着噪声、缺失和不一致,直接用于建模可能导致误导性结果。数据预处理因此成为建模流程中不可或缺的一环,而数据清洗作为其首要步骤,直接决定了模型的质量和可靠性。
一、数据清洗的重要性
数据清洗旨在识别和纠正数据中的错误、缺失和异常,确保数据的一致性和准确性[citation:1][citation:3][citation:7]。其重要性体现在多个方面:高质量的数据是模型准确性的基石。脏数据会导致算法学习到错误的模式,产生偏差,甚至使模型失效[citation:2][citation:5]。数据清洗能显著提升建模效率。通过处理缺失值和异常值,减少数据维度和复杂性,使后续特征工程和模型训练更加高效[citation:4][citation:8]。清洗后的数据增强了模型的可解释性,有助于业务决策者理解模型输出,建立信任[citation:6][citation:9]。数据清洗是满足合规性和数据治理要求的重要步骤,尤其在涉及隐私和敏感信息的领域[citation:10]。
二、常见数据清洗方法
数据清洗涵盖多种技术,针对不同类型的数据问题,常用方法包括:
1. 缺失值处理
缺失值是数据集中常见的问题,处理方法主要有:
- 删除法:当缺失比例较低且随机分布时,可删除含有缺失值的记录或特征。但需谨慎,以免丢失重要信息[citation:1][citation:4]。
- 插补法:用均值、中位数、众数或模型预测值填充缺失值。例如,对于数值型数据,均值插补简单有效;对于分类数据,众数插补更合适[citation:2][citation:7]。
- 高级插补:如多重插补、KNN插补等,利用变量间关系进行更准确的估计[citation:5][citation:9]。
2. 异常值检测与处理
异常值可能扭曲模型结果,常用检测方法包括:
- 统计方法:基于标准差(如3σ原则)或四分位距(IQR)识别异常值[citation:3][citation:6]。
- 可视化方法:通过箱线图、散点图直观发现异常点[citation:1][citation:8]。
- 模型方法:使用聚类、孤立森林等算法检测异常[citation:4][citation:10]。
处理方法有删除、替换或保留(如果异常值代表真实极端情况)。
3. 噪声数据平滑
噪声是数据中的随机误差,平滑技术包括:
- 分箱法:将数据排序后分箱,用箱均值或中位数平滑[citation:2][citation:5]。
- 回归法:拟合回归模型平滑噪声[citation:7][citation:9]。
- 聚类法:识别并去除离群簇[citation:3][citation:8]。
4. 重复记录处理
重复记录会导致模型过度拟合,需通过记录匹配和去重技术识别并合并重复项[citation:1][citation:6]。
5. 数据一致性校验
确保数据格式、范围和逻辑一致,例如统一日期格式、检查数值范围、验证编码一致性等[citation:4][citation:10]。
三、
数据清洗是数据预处理的基础,对建模成功至关重要。通过系统处理缺失值、异常值、噪声和重复数据,可以显著提升数据质量,进而提高模型的准确性、效率和可解释性。在实际应用中,应根据数据特性和业务需求选择合适的清洗方法,并迭代验证清洗效果,为后续建模奠定坚实基础。
如若转载,请注明出处:http://www.newbeedata.com/product/43.html
更新时间:2026-11-01 02:44:05